画像・PDFの日本語を、端末内でテキストに。
紙の資料や画像の文字を、コピーして使えるテキストへ。OptiScanは、画像やPDFから文字を読み取るAndroidアプリです。
国立国会図書館が公開する「NDLOCR-Lite」をもとに、スマートフォンで資料のテキスト化から確認・保存まで行えるようにしました。本や雑誌、仕事の書類、学習資料などを、手入力する手間を減らして活用できます。
Google Playで公開準備中です。リンク先は公開後にご利用いただけます。
日本語の縦書き・横書きに対応
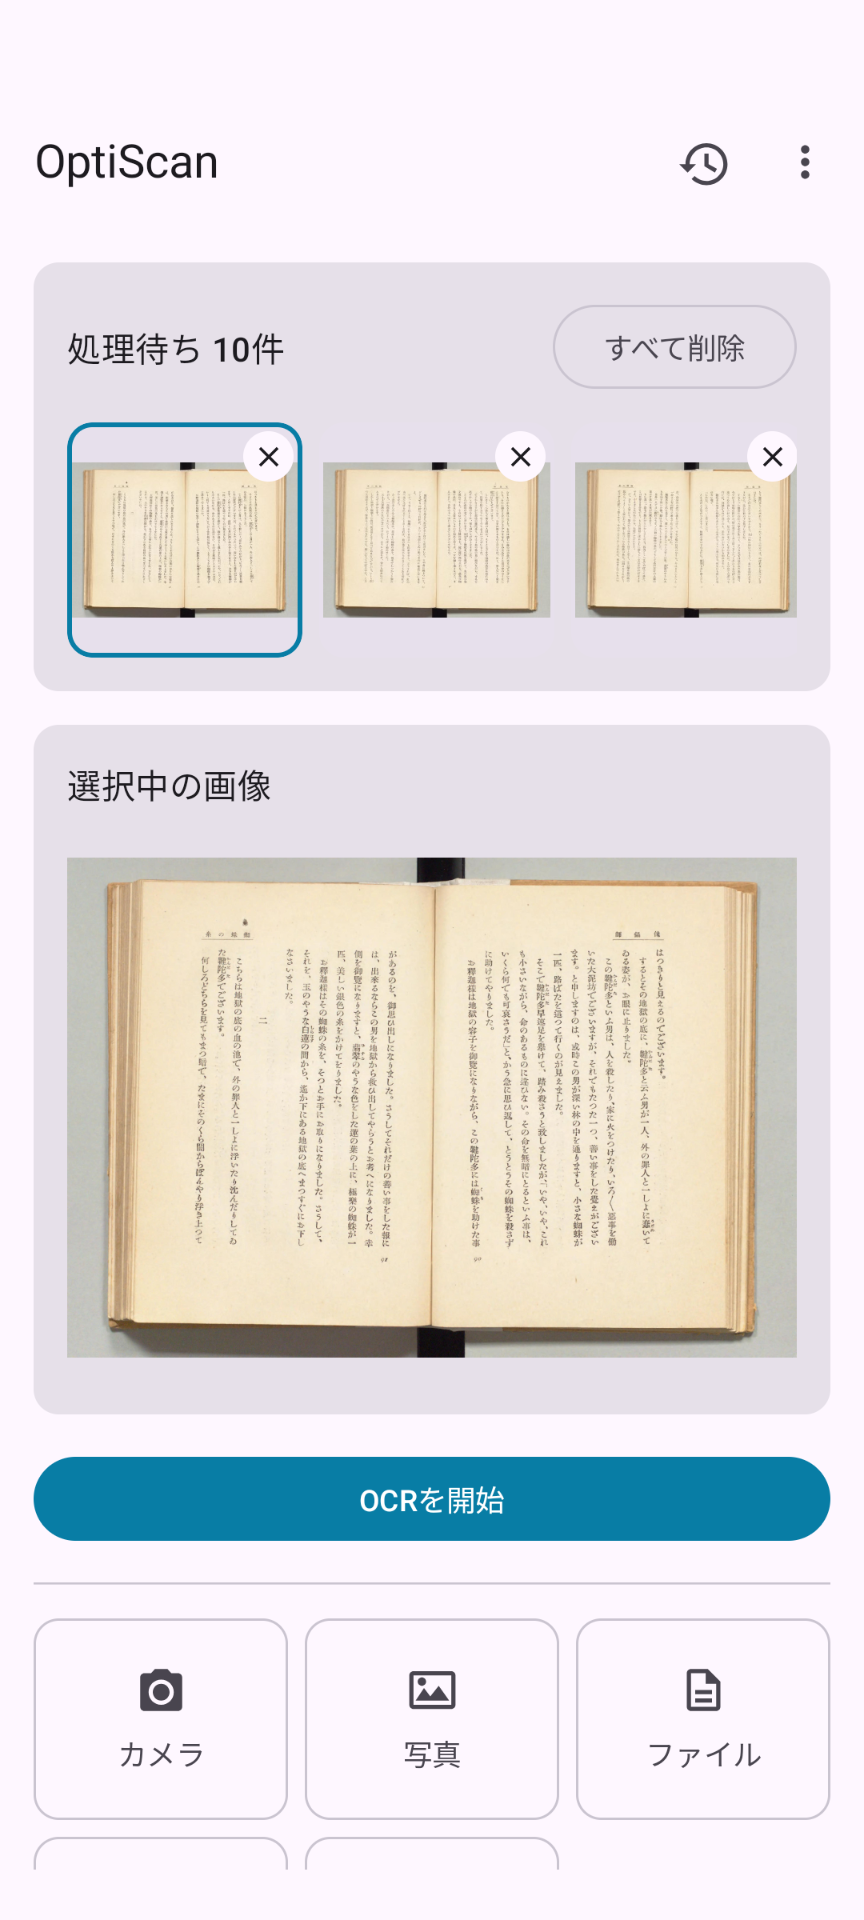
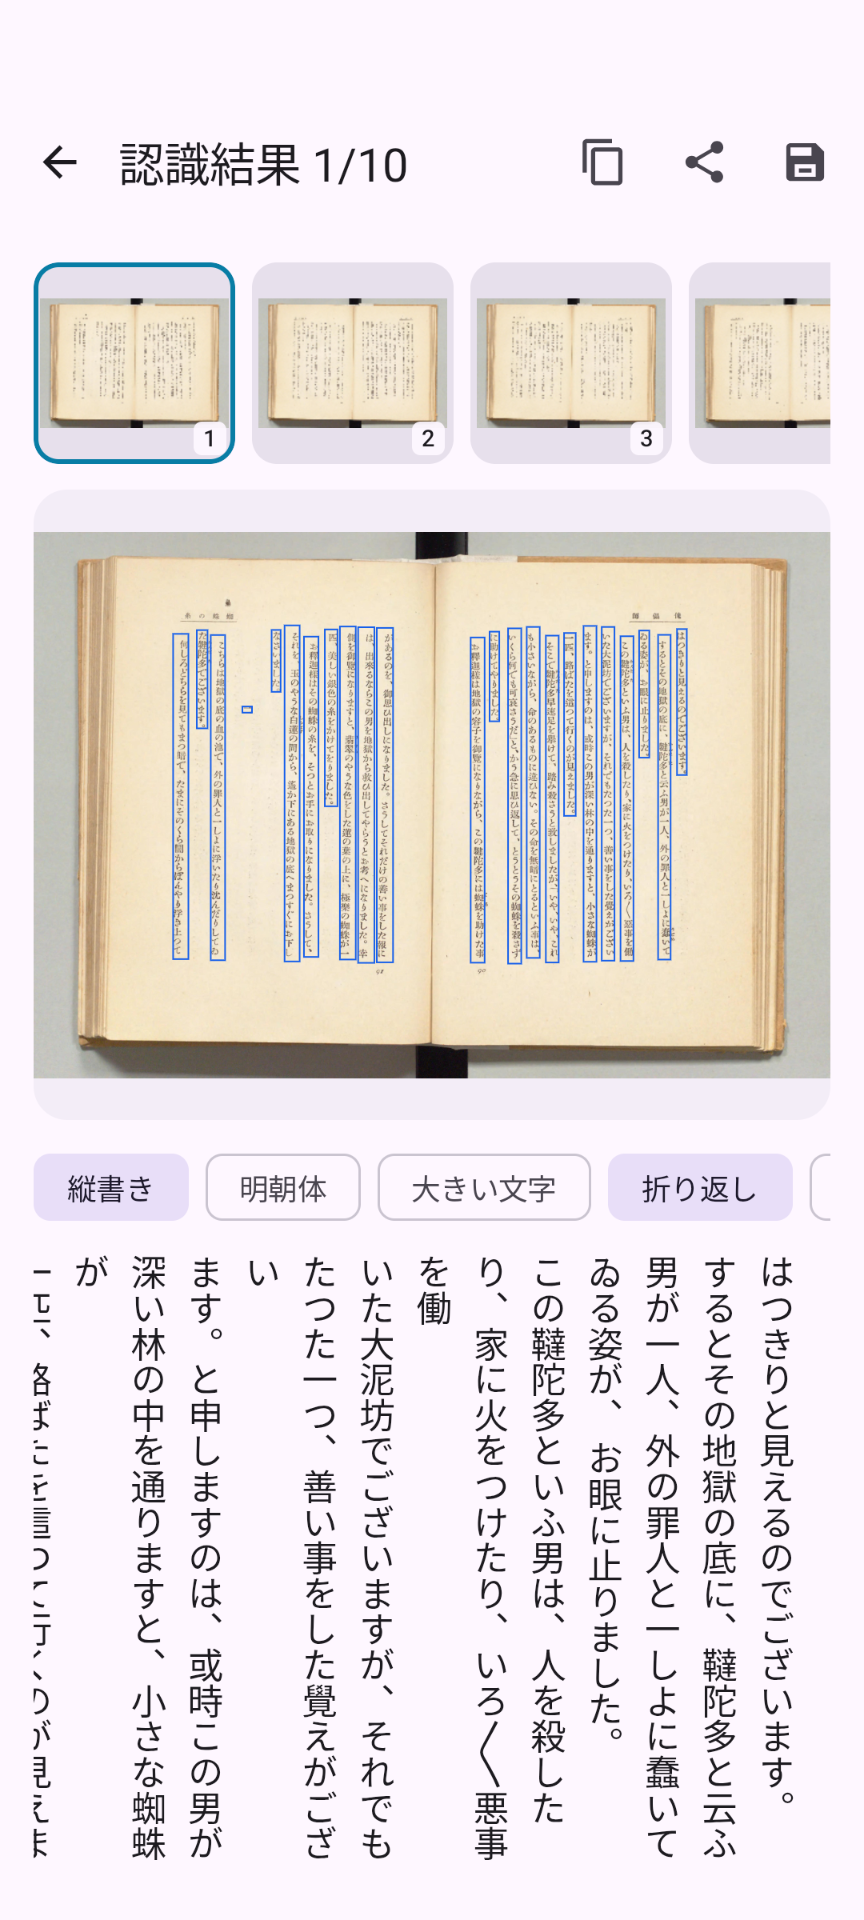
縦書きの本や横書きの書類など、日本語の資料をテキスト化できます。認識結果は元画像と見比べながら確認でき、画像を拡大して細かな文字も確かめられます。
OCRはすべて端末内で処理
文字認識モデルはアプリに同梱しているため、OCR処理にインターネット接続は不要です。取り込んだ画像や認識結果を当社のサーバーや外部のAIサービスへ送信せず、アカウント登録も必要ありません。
URLから画像やPDFを取り込む場合や、外部サイトを開く場合には通信が発生します。
取り込んで、進み具合を確認する
カメラでの撮影、端末内の写真・ファイル、クリップボード、画像やPDFのURLから取り込めます。複数の画像は順序を確認してから追加でき、複数ページのPDFもまとめて処理できます。
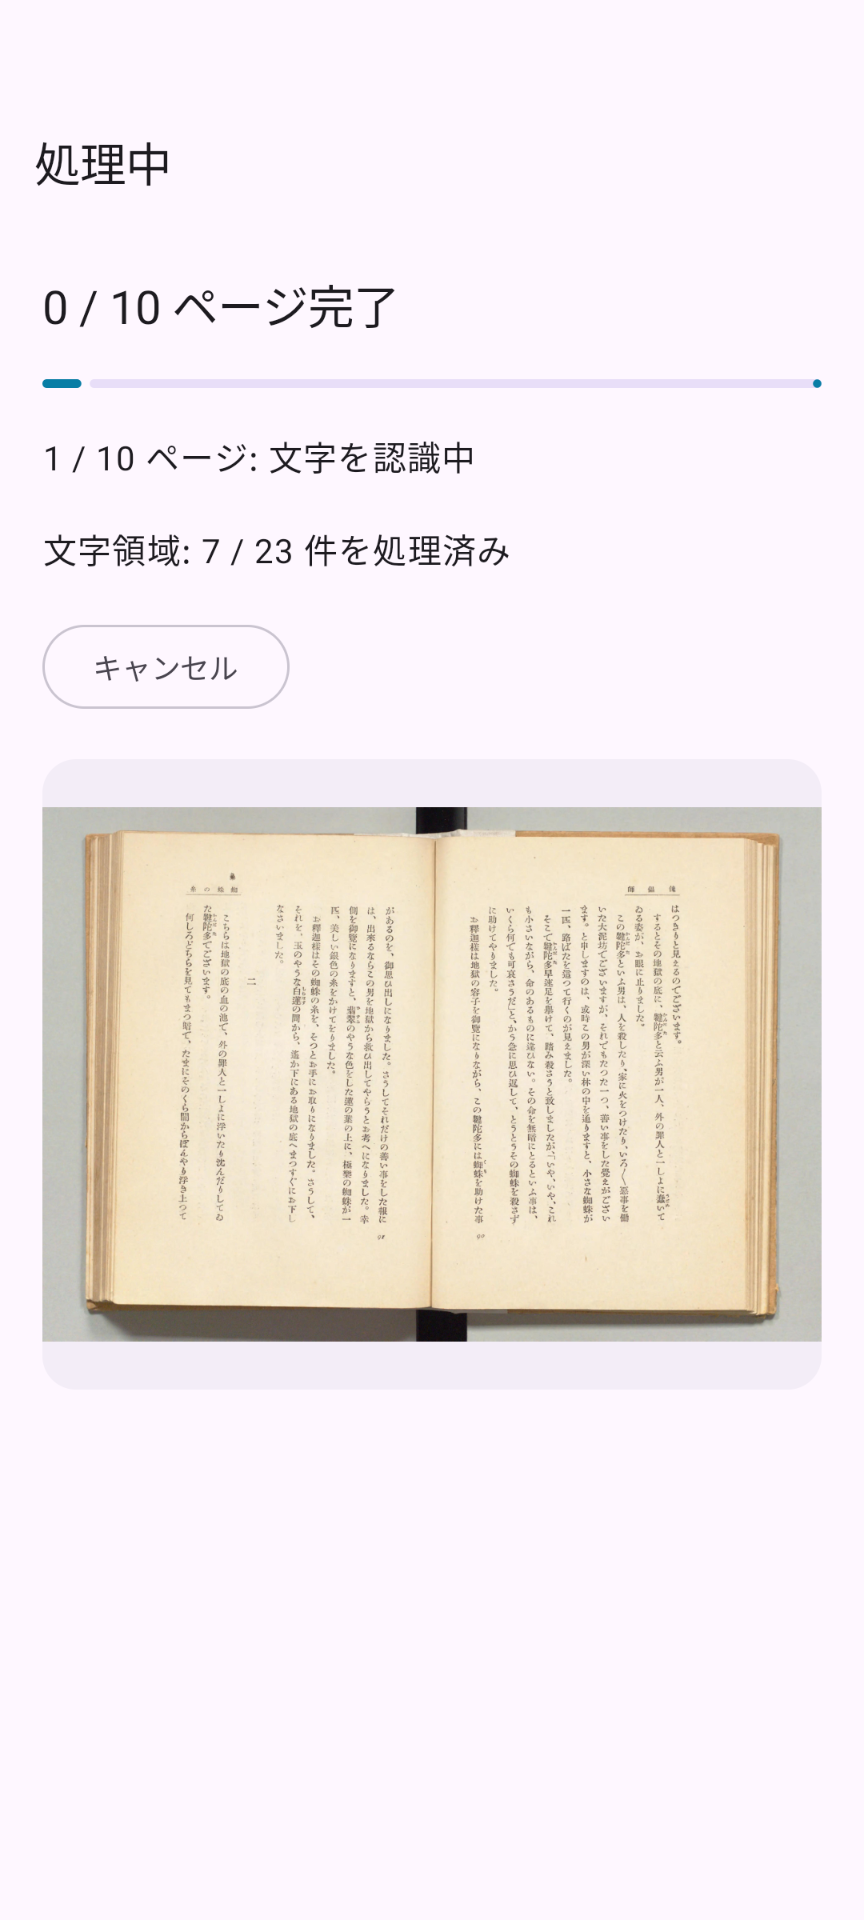
処理中は画面や通知で進捗を確認できます。アプリの画面を閉じても処理を続けられ、必要に応じてキャンセルできます。中断した場合は、未処理のページから再開できます。
読みやすく表示して、必要な場所へ
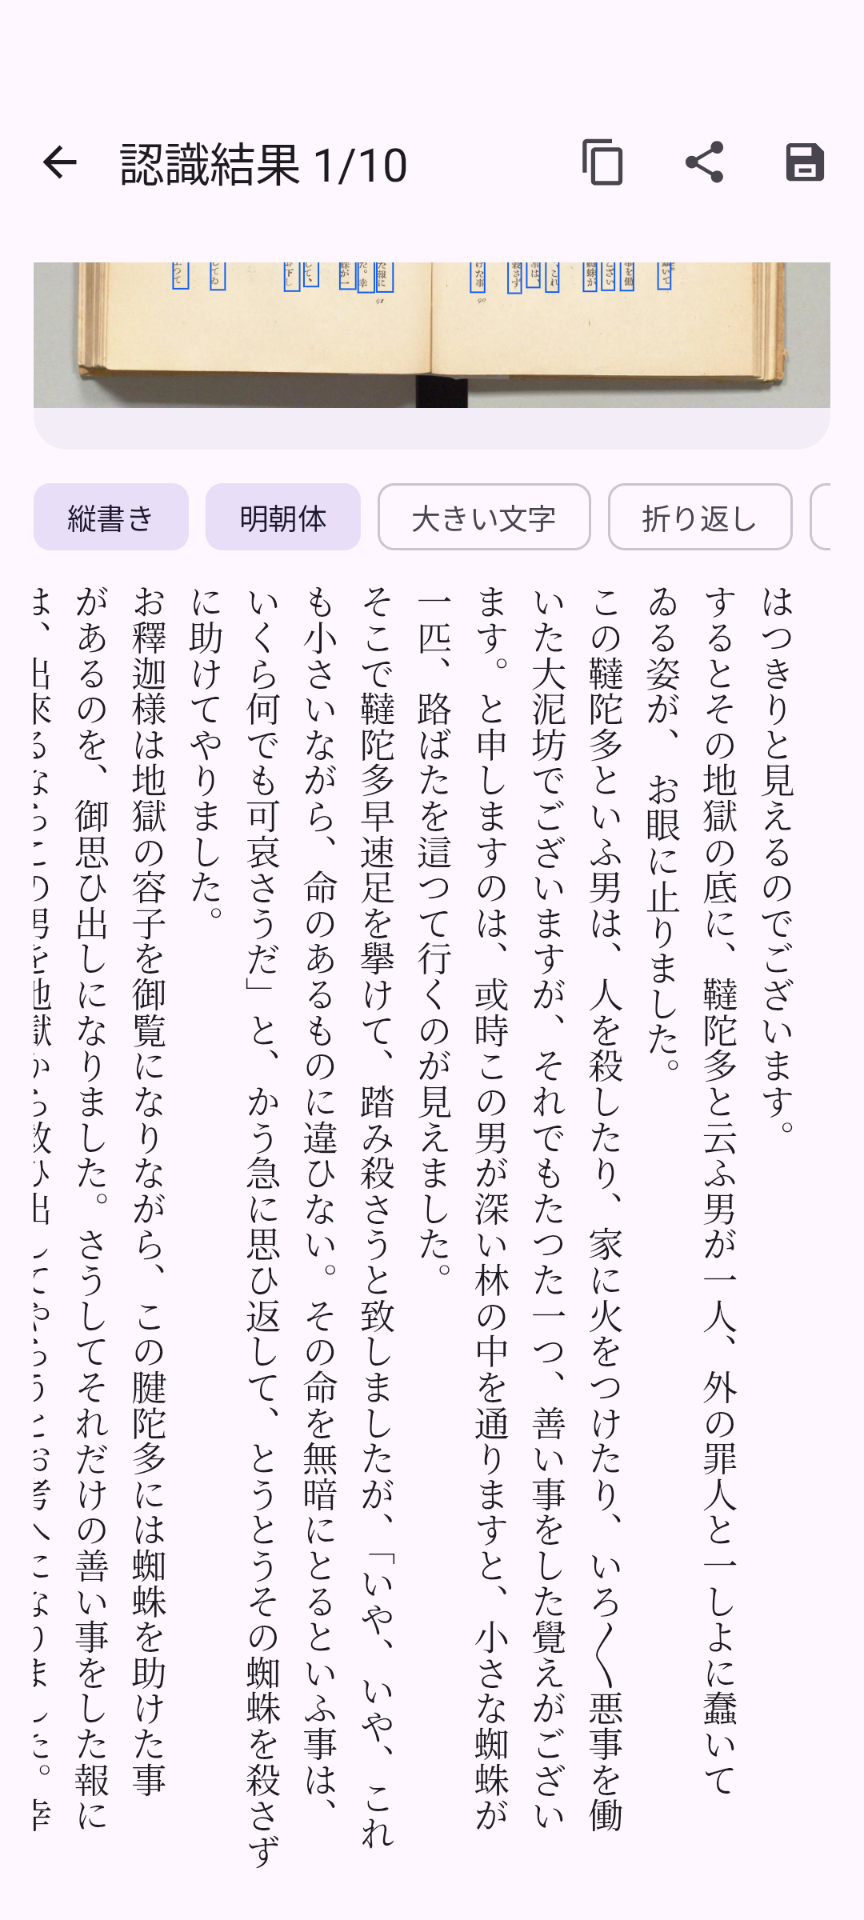
認識した文章は、縦書き・横書き、文字サイズ、明朝体、折り返しなどの表示を調整できます。不要な改行を除去し、テキストのコピー、他のアプリへの共有、テキストファイル(UTF-8)への保存ができます。
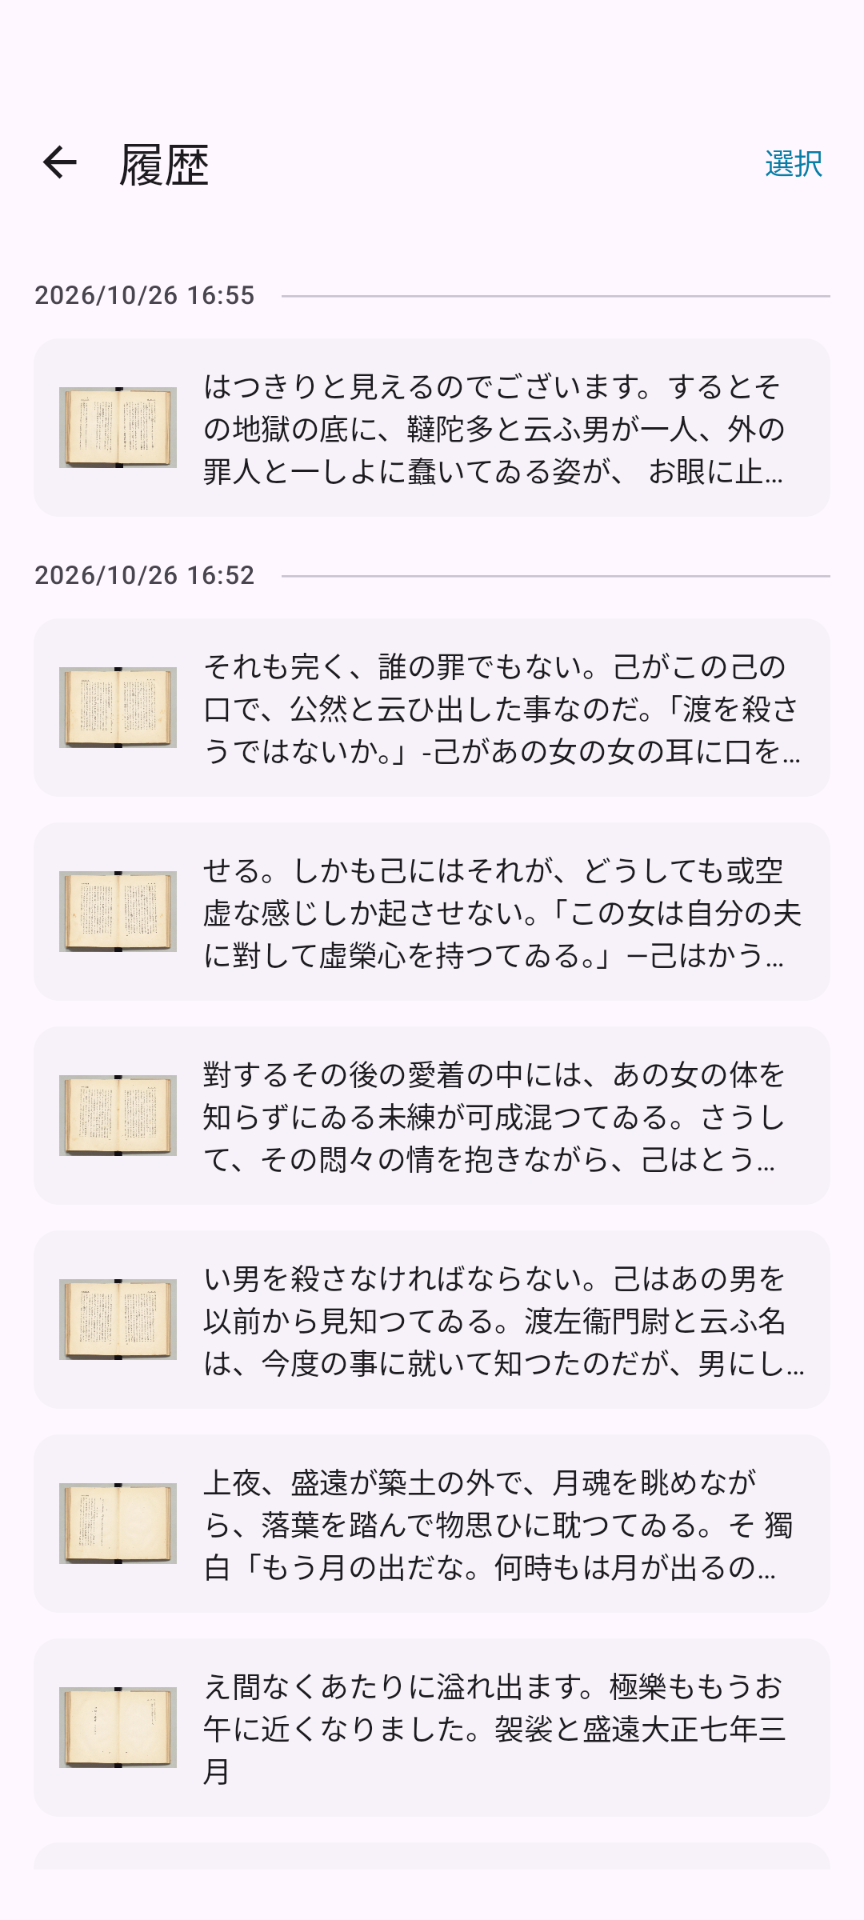
取り込んだ画像と認識結果は端末内に保存されます。履歴には画像のサムネイルと文章の一部が表示され、過去の結果を開き直せます。不要になった画像と結果は、個別に、またはまとめて削除できます。
こんな場面に
- 本や雑誌の文章を、読書メモや調べものに活用したいとき
- 紙の書類や配布資料を、入力し直さずテキストにしたいとき
- スキャンしたPDFから、必要な文章を取り出したいとき
- 通信できない場所でも、端末内の資料を文字認識したいとき
NDLOCR-Liteについて・謝辞
OptiScanは、国立国会図書館が開発・公開するNDLOCR-Liteの文字認識モデル、文字セット、推論アルゴリズムを活用し、ブライテクノ株式会社がAndroid向けに開発したアプリです。
NDLOCR-Liteを公開してくださった国立国会図書館と、関連技術の開発・公開に携わった皆さまに感謝いたします。詳しい出典とライセンスは、アプリ内の「クレジット」「ライセンス」から確認できます。
ご利用にあたって
認識結果は、画像の解像度、文字の状態、資料のレイアウトなどによって異なります。大切な文章は元画像と照合してご利用ください。