古典籍や古い書物の文字を、端末内でテキストに。
古い書物の画像を、コピーして使えるテキストへ。Koten Deckは、古典籍に特化した文字認識モデルで画像やPDFを読み取るiOSアプリです。
OCR Deckの使いやすさはそのままに、文字認識モデルを古典籍などの古い書物に特化したモデルへ差し替えました。資料の取り込みから認識結果の確認・保存まで、スマートフォンで完結できます。
公開準備中
古典籍などの文字認識に特化
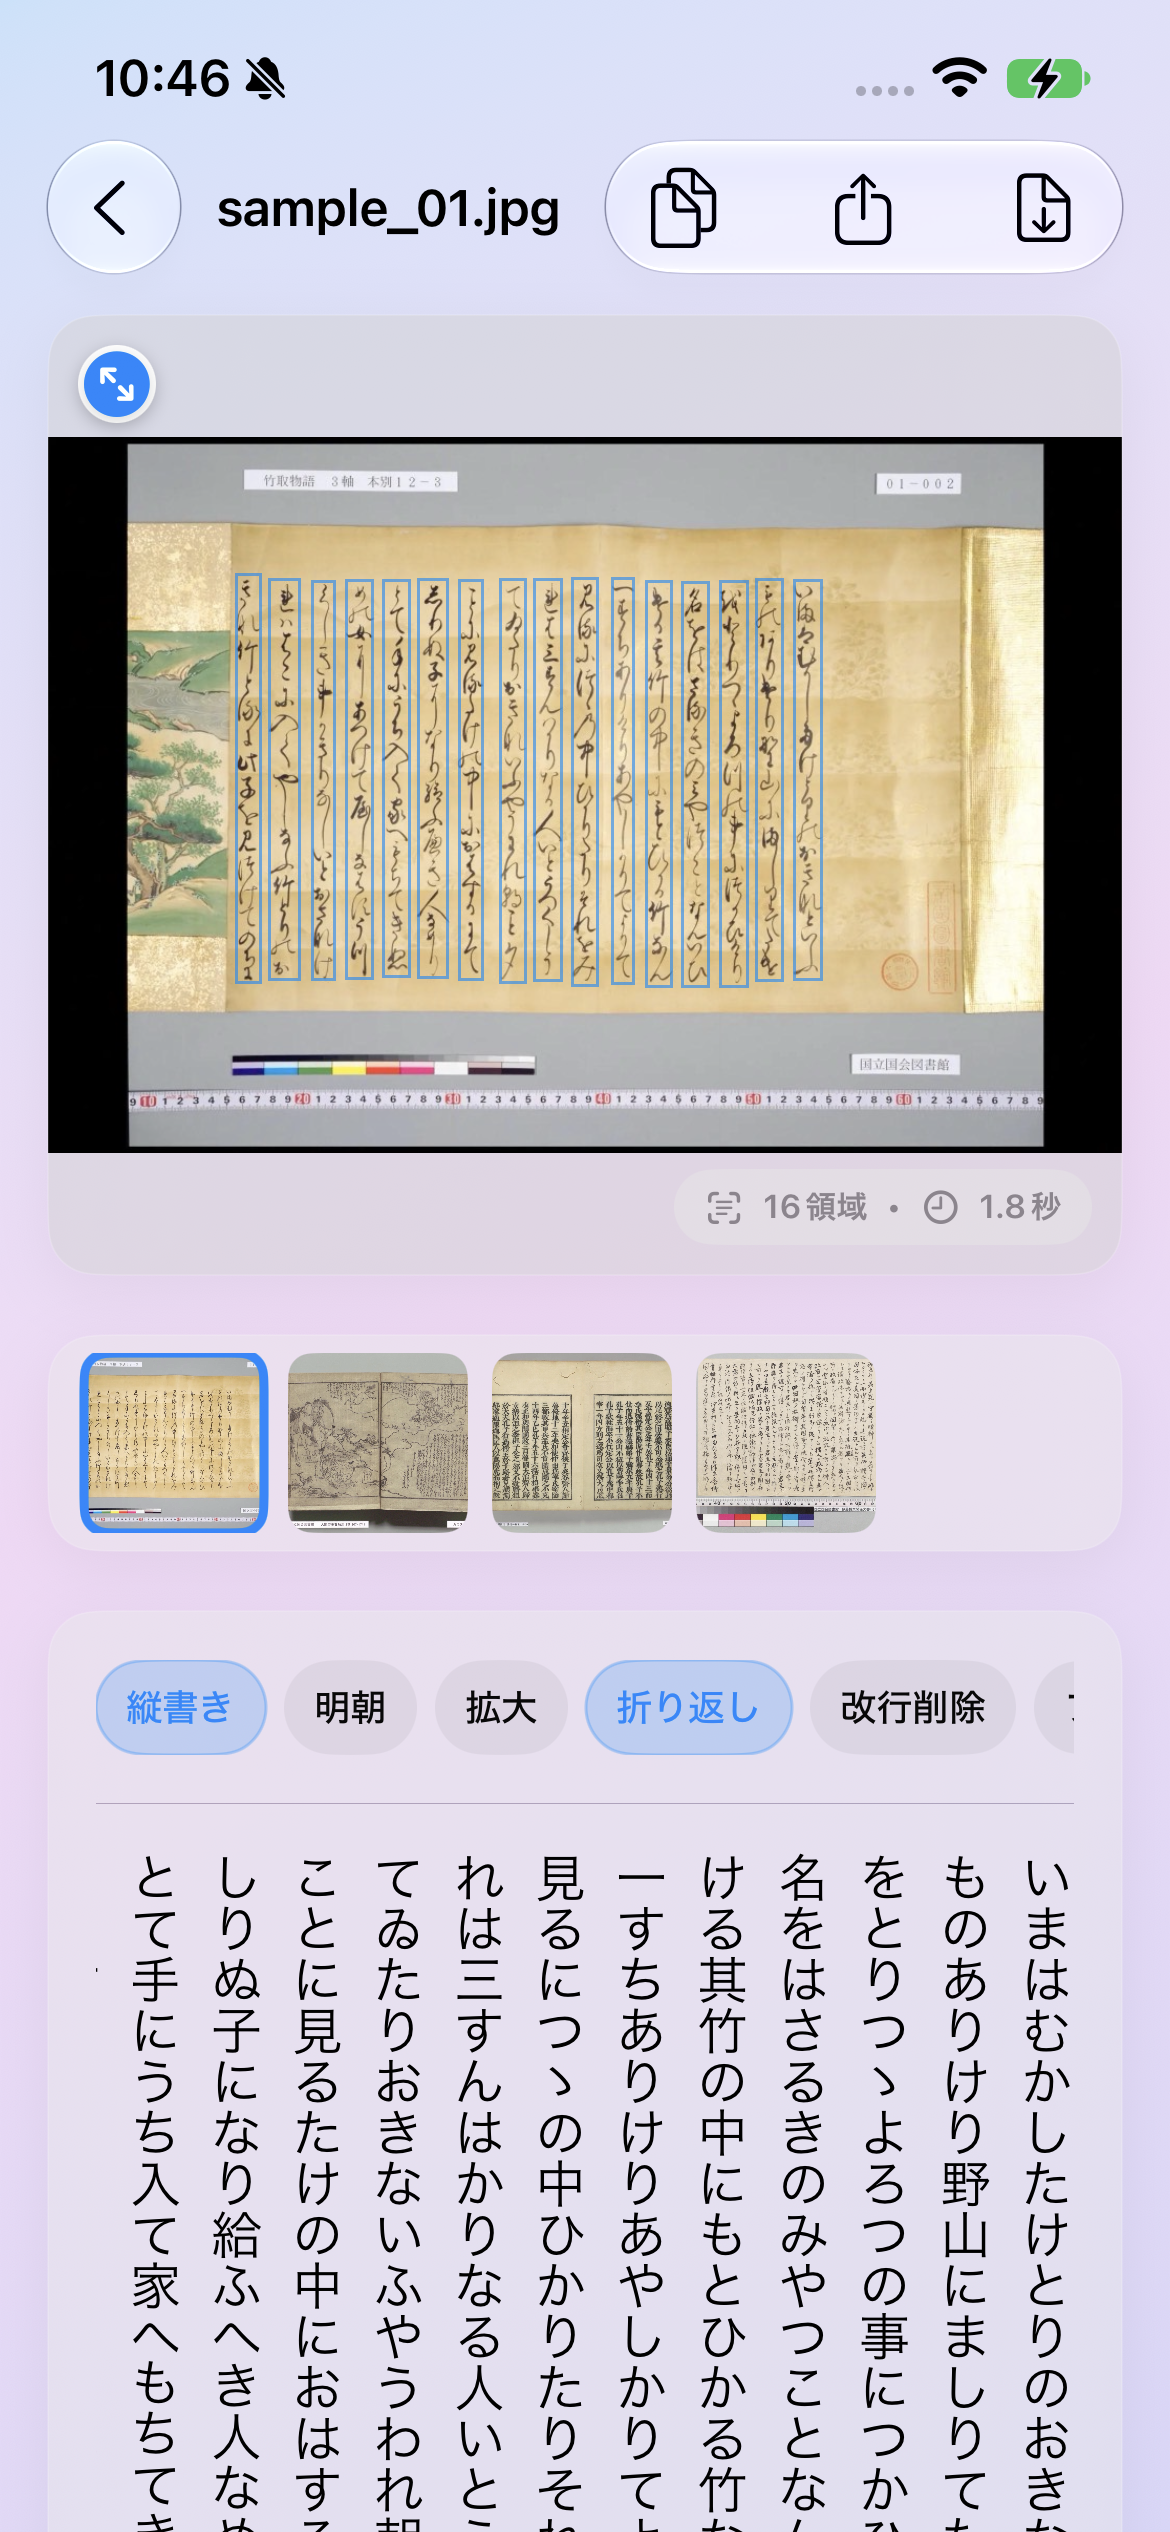
古典籍や古い書物に見られる文字を読み取り、活用しやすいテキストへ変換します。認識結果は元画像と見比べながら確認でき、画像を拡大して細かな文字も確かめられます。
OCRはすべて端末内で処理
文字認識モデルはアプリに同梱しているため、OCR処理にインターネット接続は不要です。取り込んだ画像や認識結果を当社のサーバーや外部のAIサービスへ送信せず、アカウント登録も必要ありません。
URLから画像やPDFを取り込む場合や、外部サイトを開く場合には通信が発生します。
取り込んで、進み具合を確認する
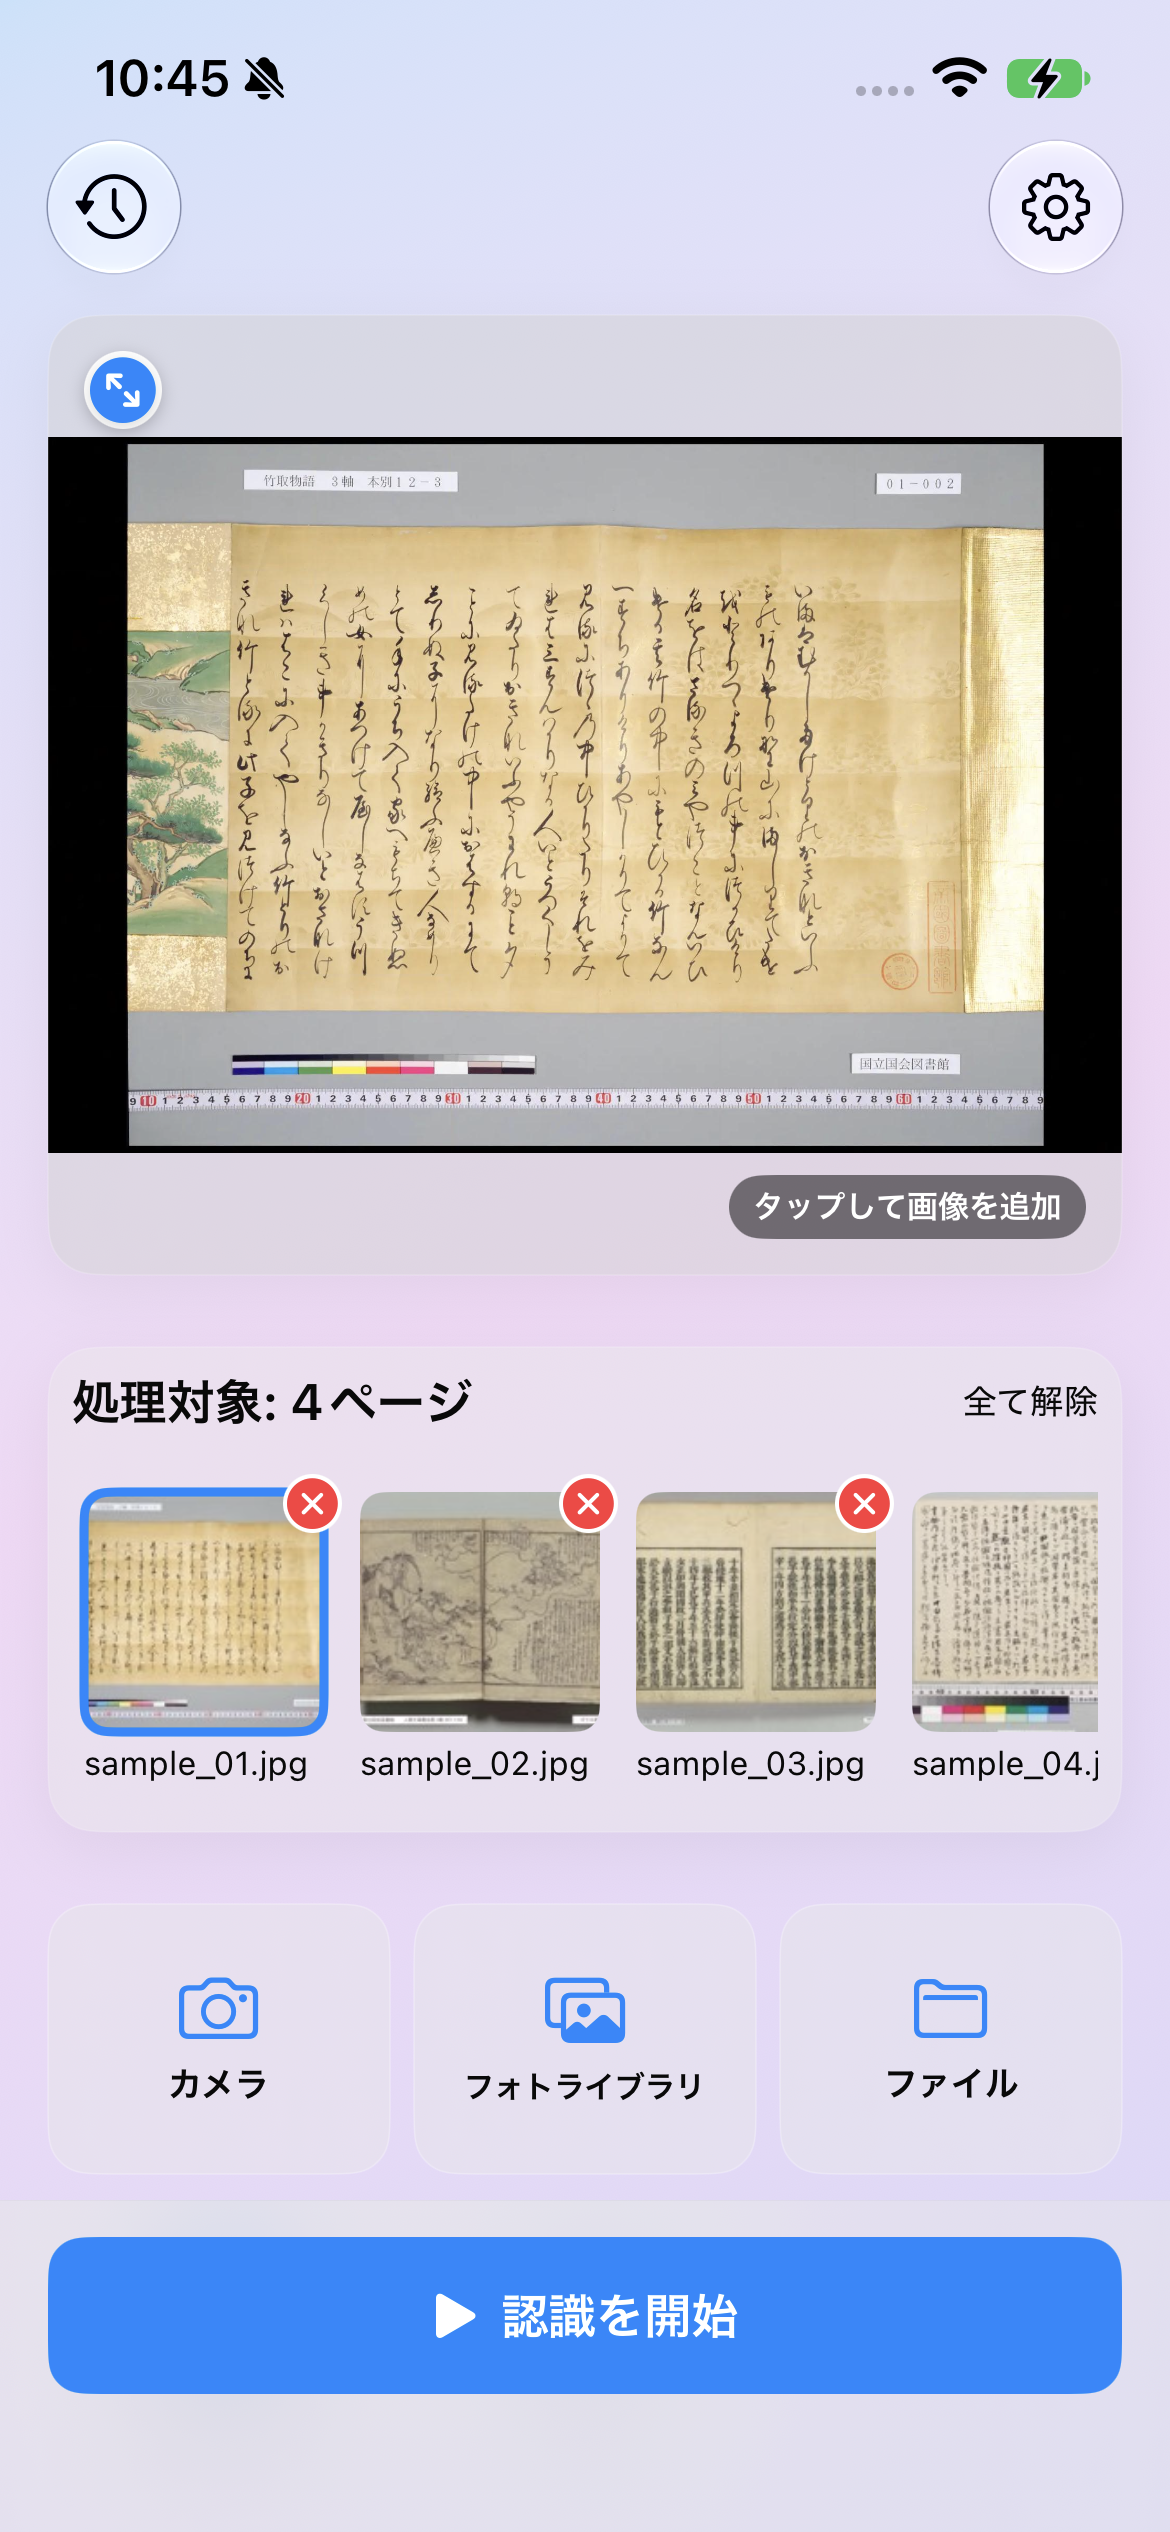
カメラでの撮影、端末内の写真・ファイル、クリップボード、画像やPDFのURLから取り込めます。複数の画像は順序を確認してから追加でき、複数ページのPDFもまとめて処理できます。
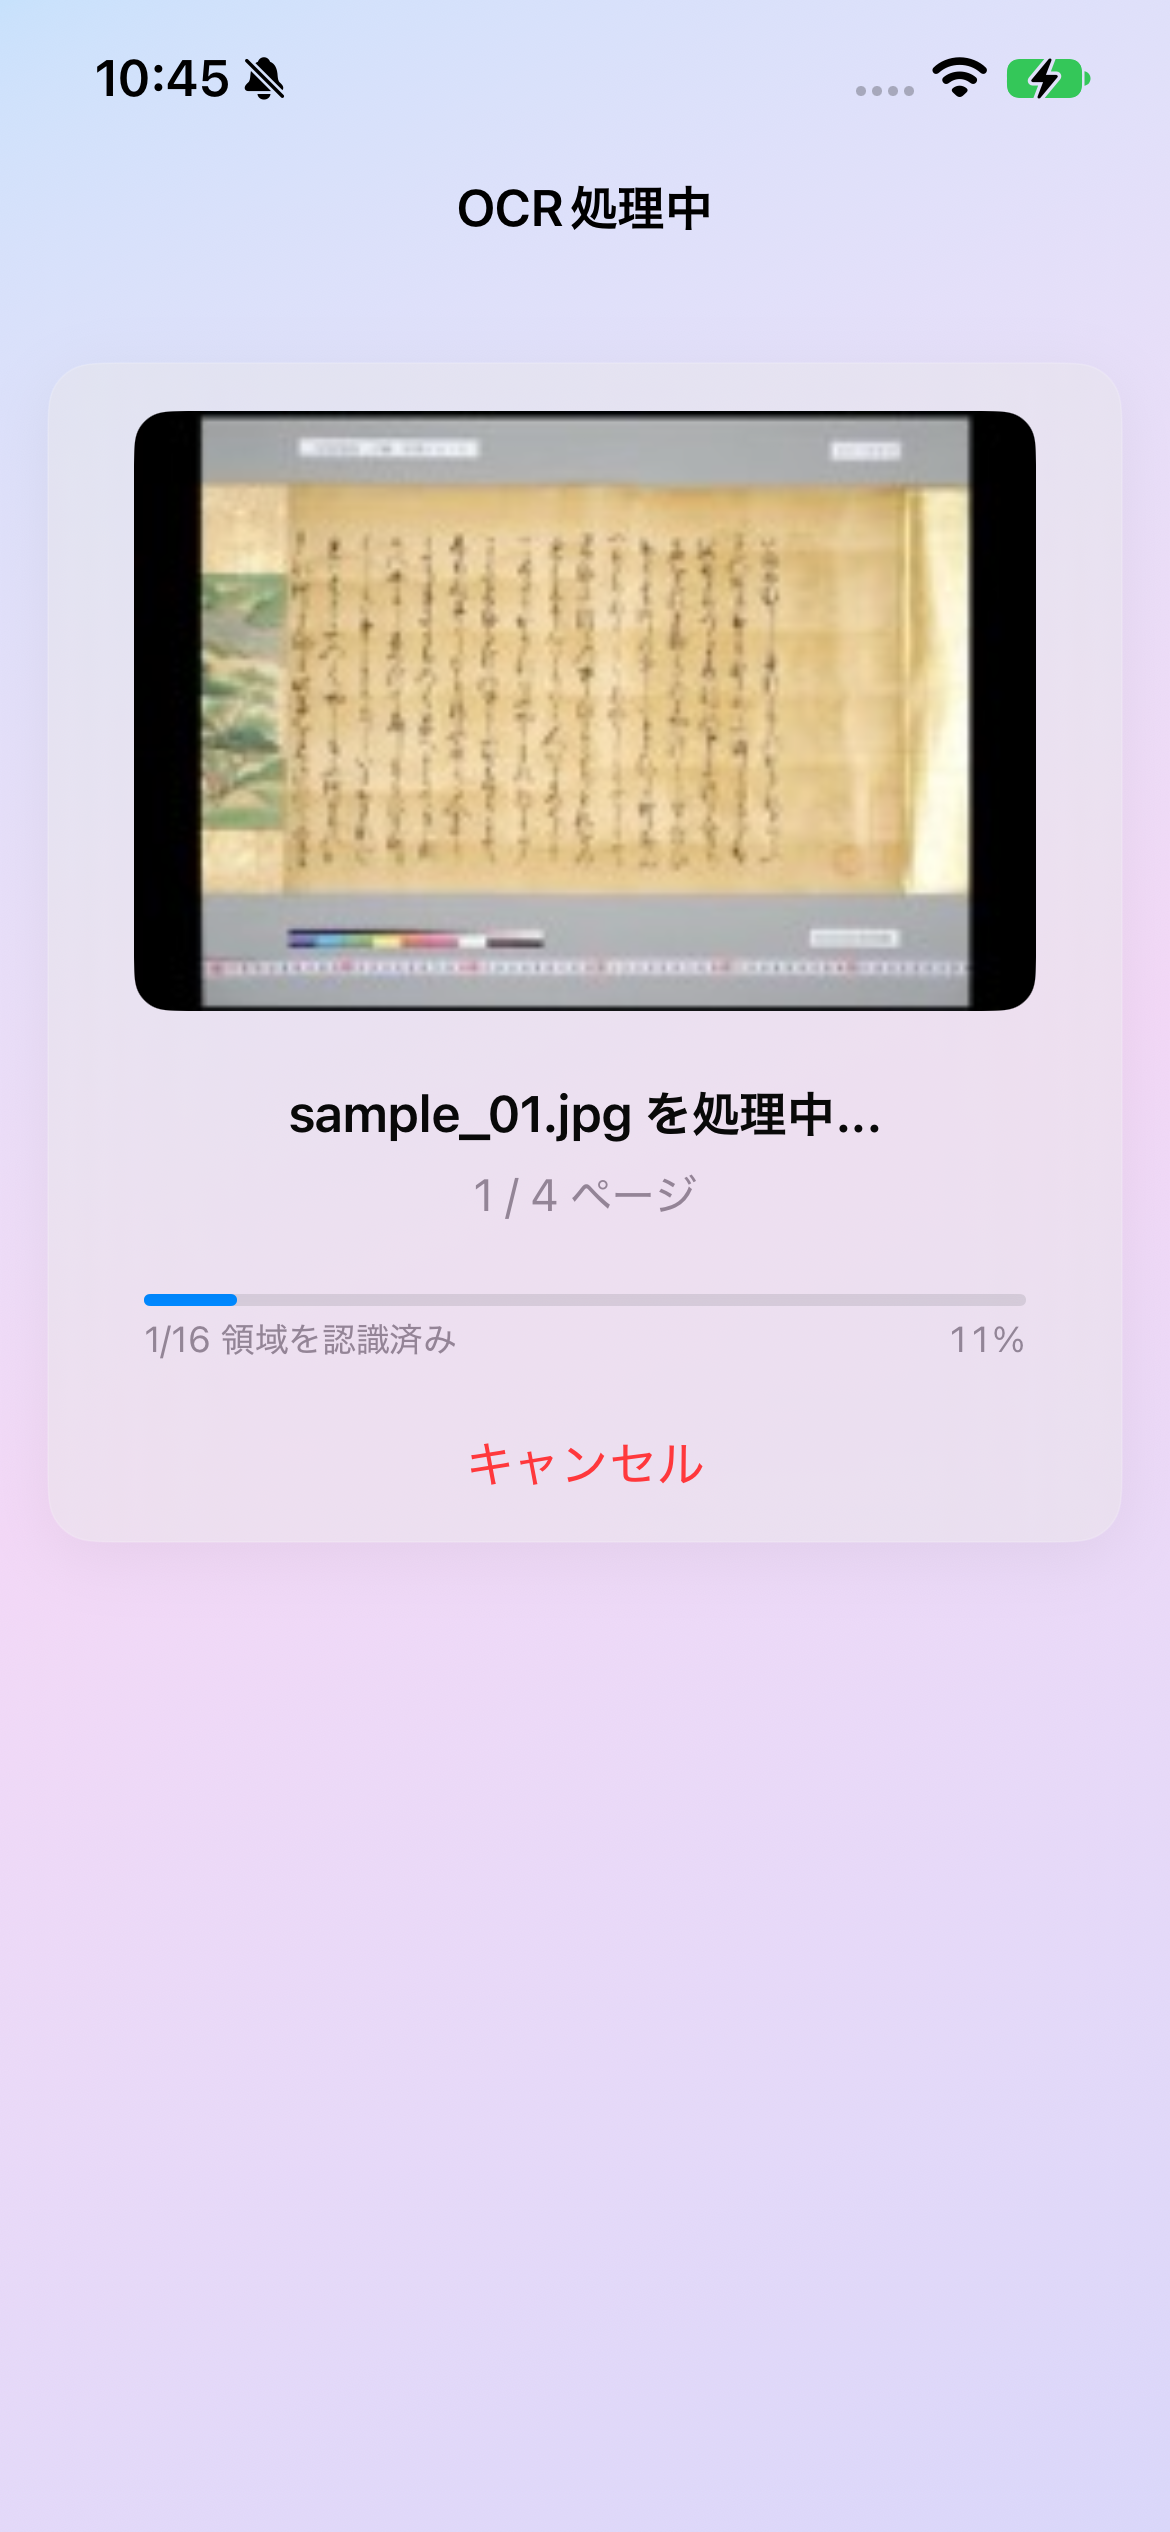
複数ページの資料も、処理画面で進み具合を確認できます。
読みやすく表示して、必要な場所へ
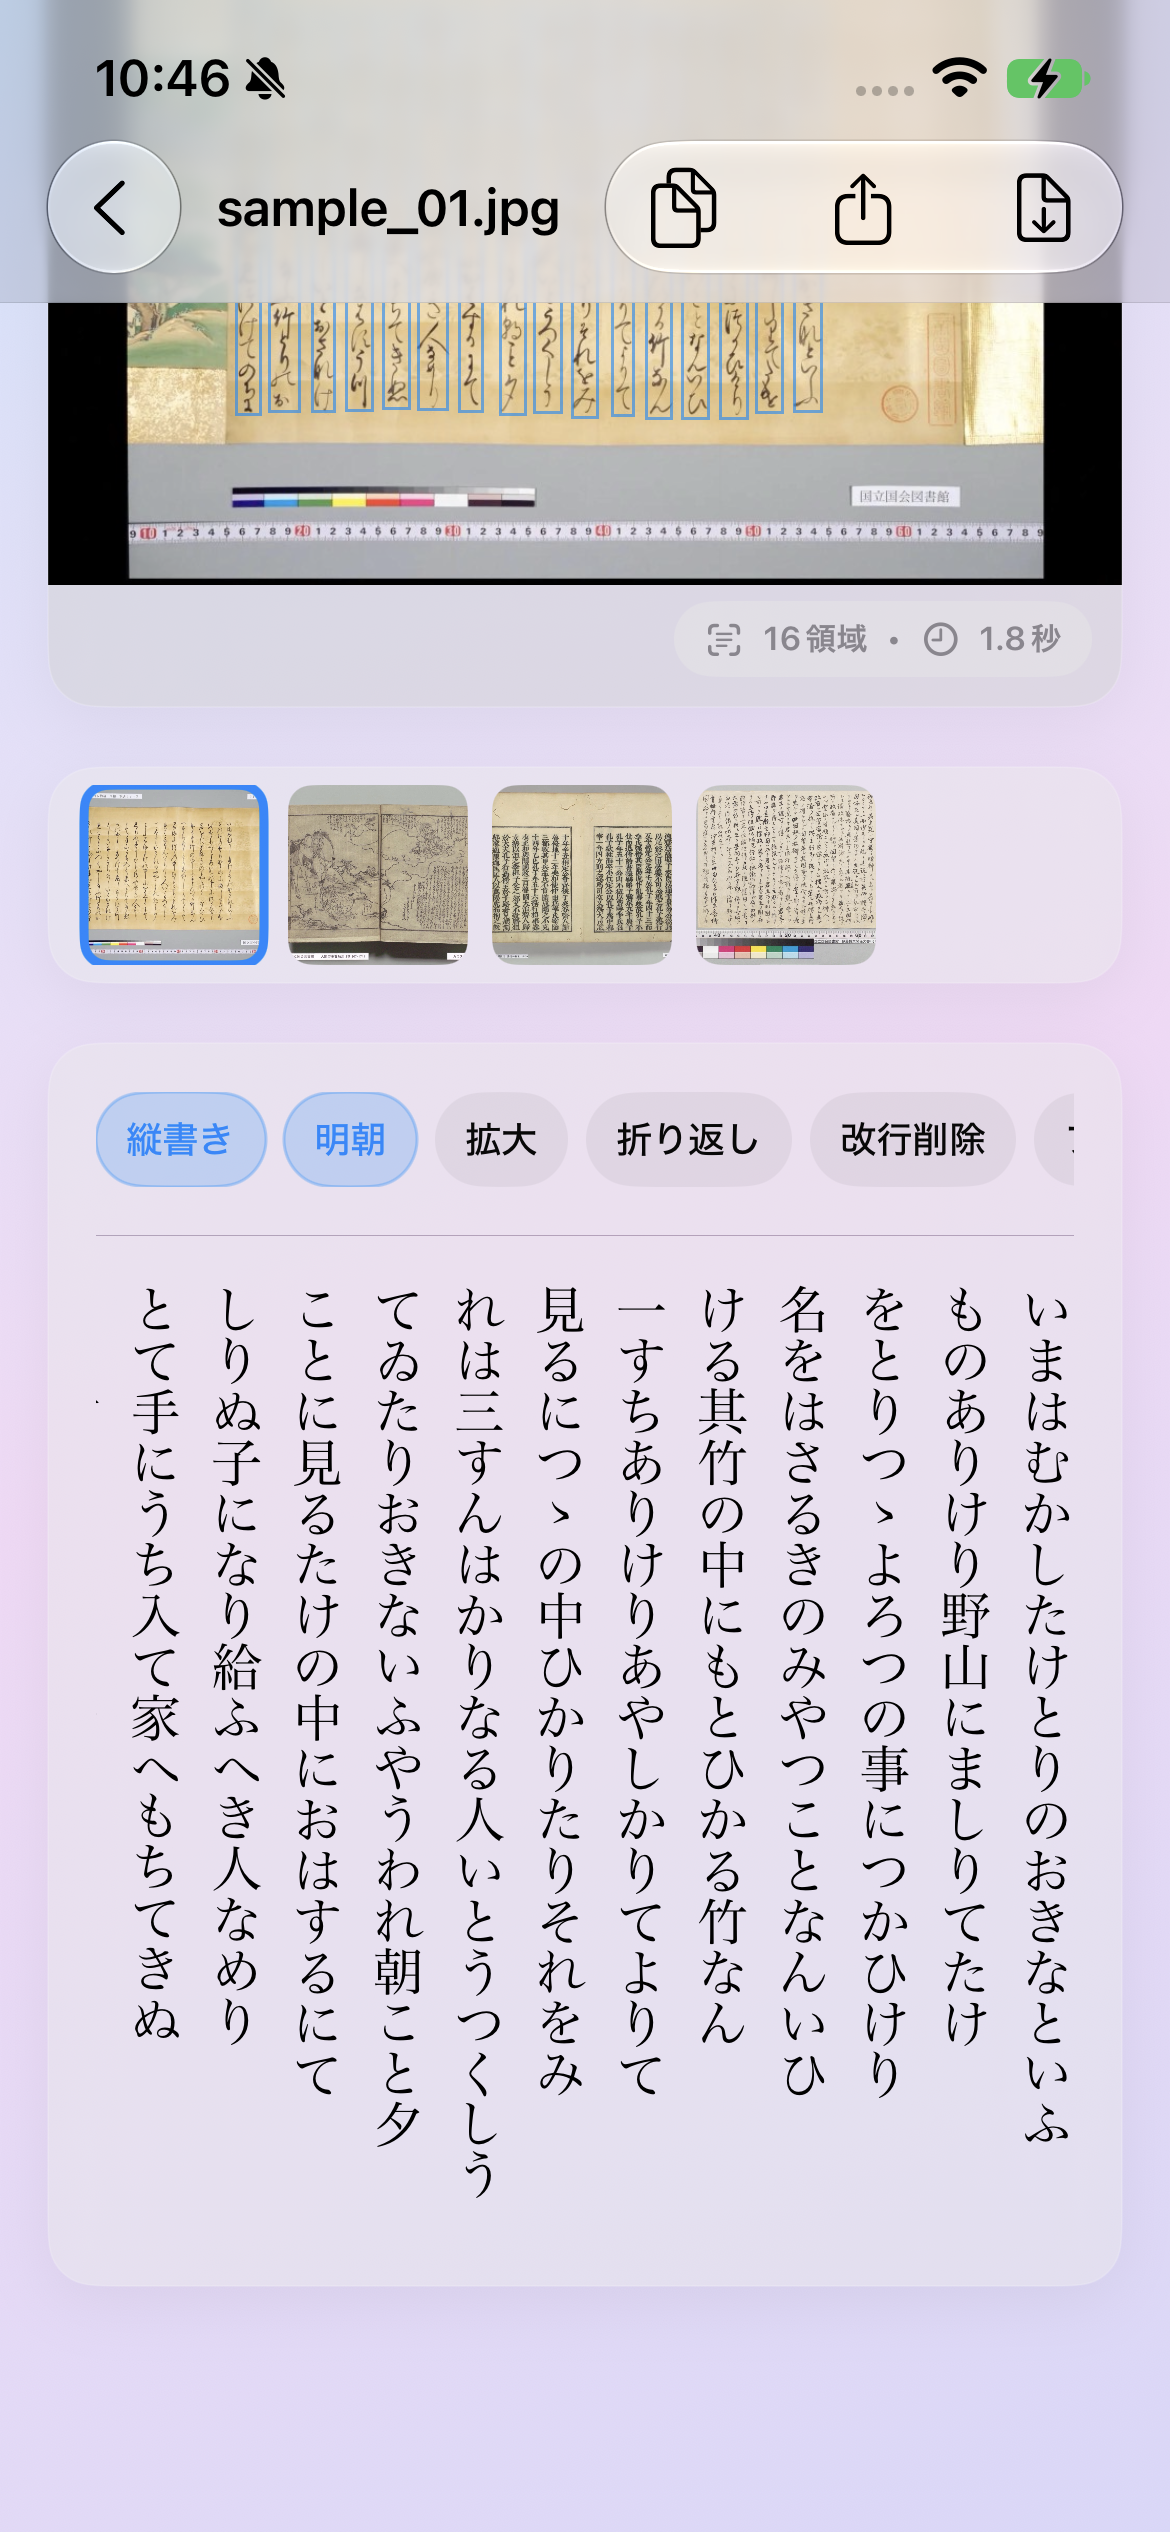
認識した文章は、縦書き・横書き、文字サイズ、明朝体、折り返しなどの表示を調整できます。不要な改行を除去し、テキストのコピー、他のアプリへの共有、テキストファイル(UTF-8)への保存ができます。
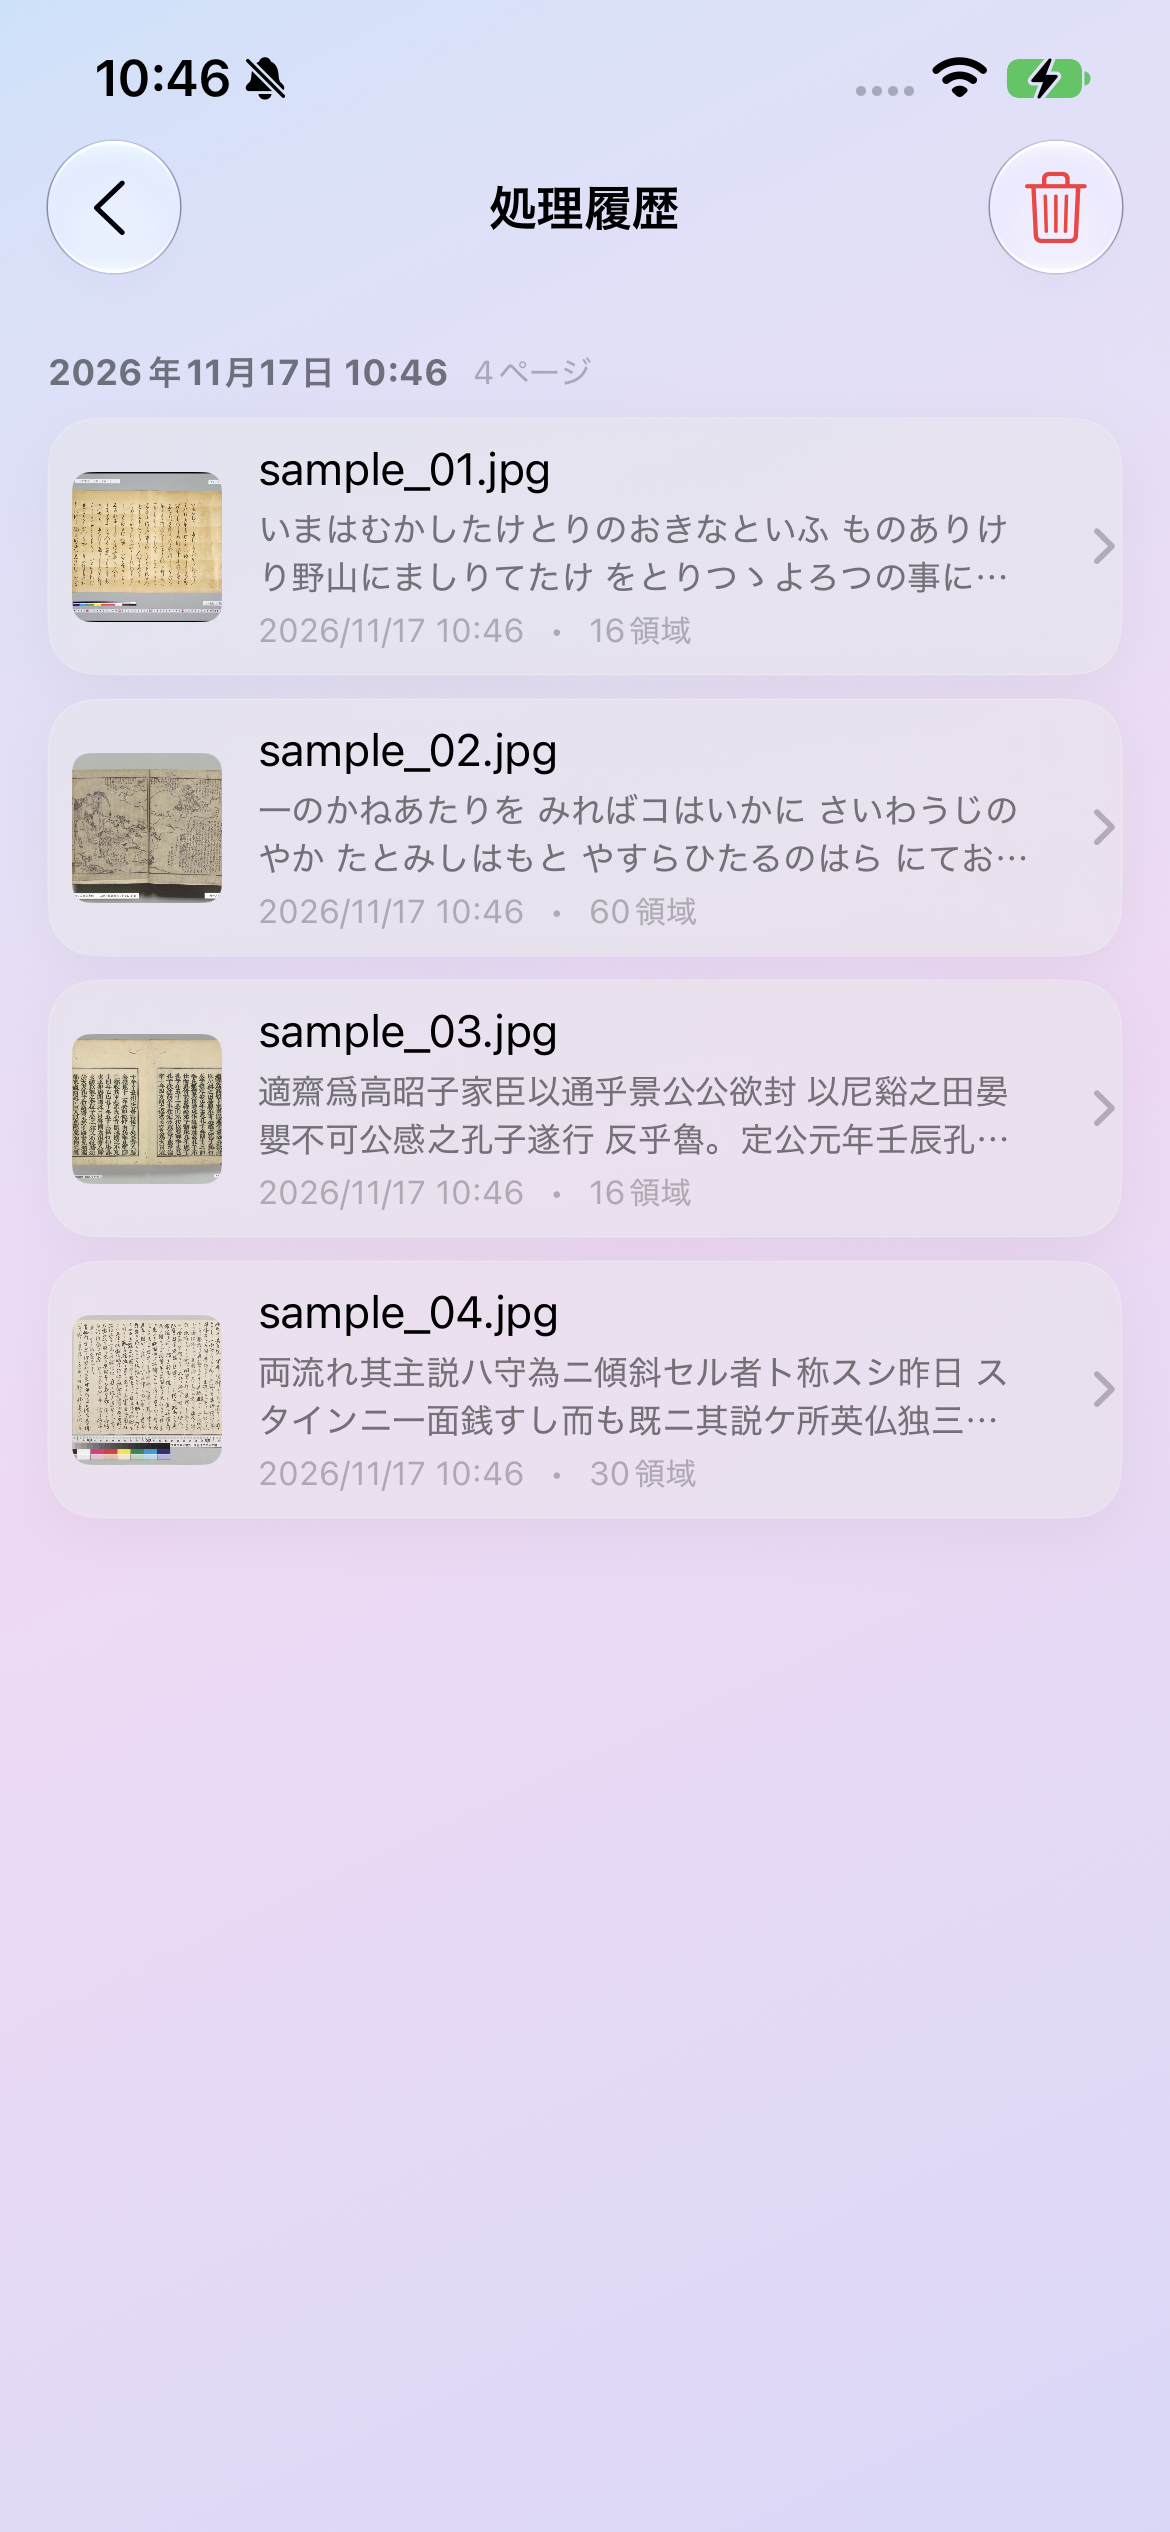
取り込んだ画像と認識結果は端末内に保存されます。履歴から過去の結果を開き直し、不要になった画像と結果を削除できます。
こんな場面に
- 古典籍や古い書物の内容を、調査や研究に活用したいとき
- 資料の文章を、手入力せずテキストとして取り出したいとき
- スキャンした古い資料のPDFから、必要な文章を取り出したいとき
- 通信できない場所でも、端末内の資料を文字認識したいとき
NDL古典籍OCR-Liteについて・謝辞
Koten Deckは、国立国会図書館が開発・公開するNDL古典籍OCR-Liteの文字認識モデルを活用し、ブライテクノ株式会社がiOS向けに開発したアプリです。
NDL古典籍OCR-Liteを公開してくださった国立国会図書館と、関連技術の開発・公開に携わった皆さまに感謝いたします。詳しい出典とライセンスは、アプリ内の「クレジット」「ライセンス」から確認できます。
国立国会図書館「NDL古典籍OCR-Liteの公開について」
ご利用にあたって
認識結果は、画像の解像度、文字の状態、資料のレイアウトなどによって異なります。大切な文章は元画像と照合してご利用ください。